Vemus未音最新版
- v1.4.0
- 安卓影音视听
 安全
-
更新时间2026-09-14
-
大小79.4M
-
语言中文
0
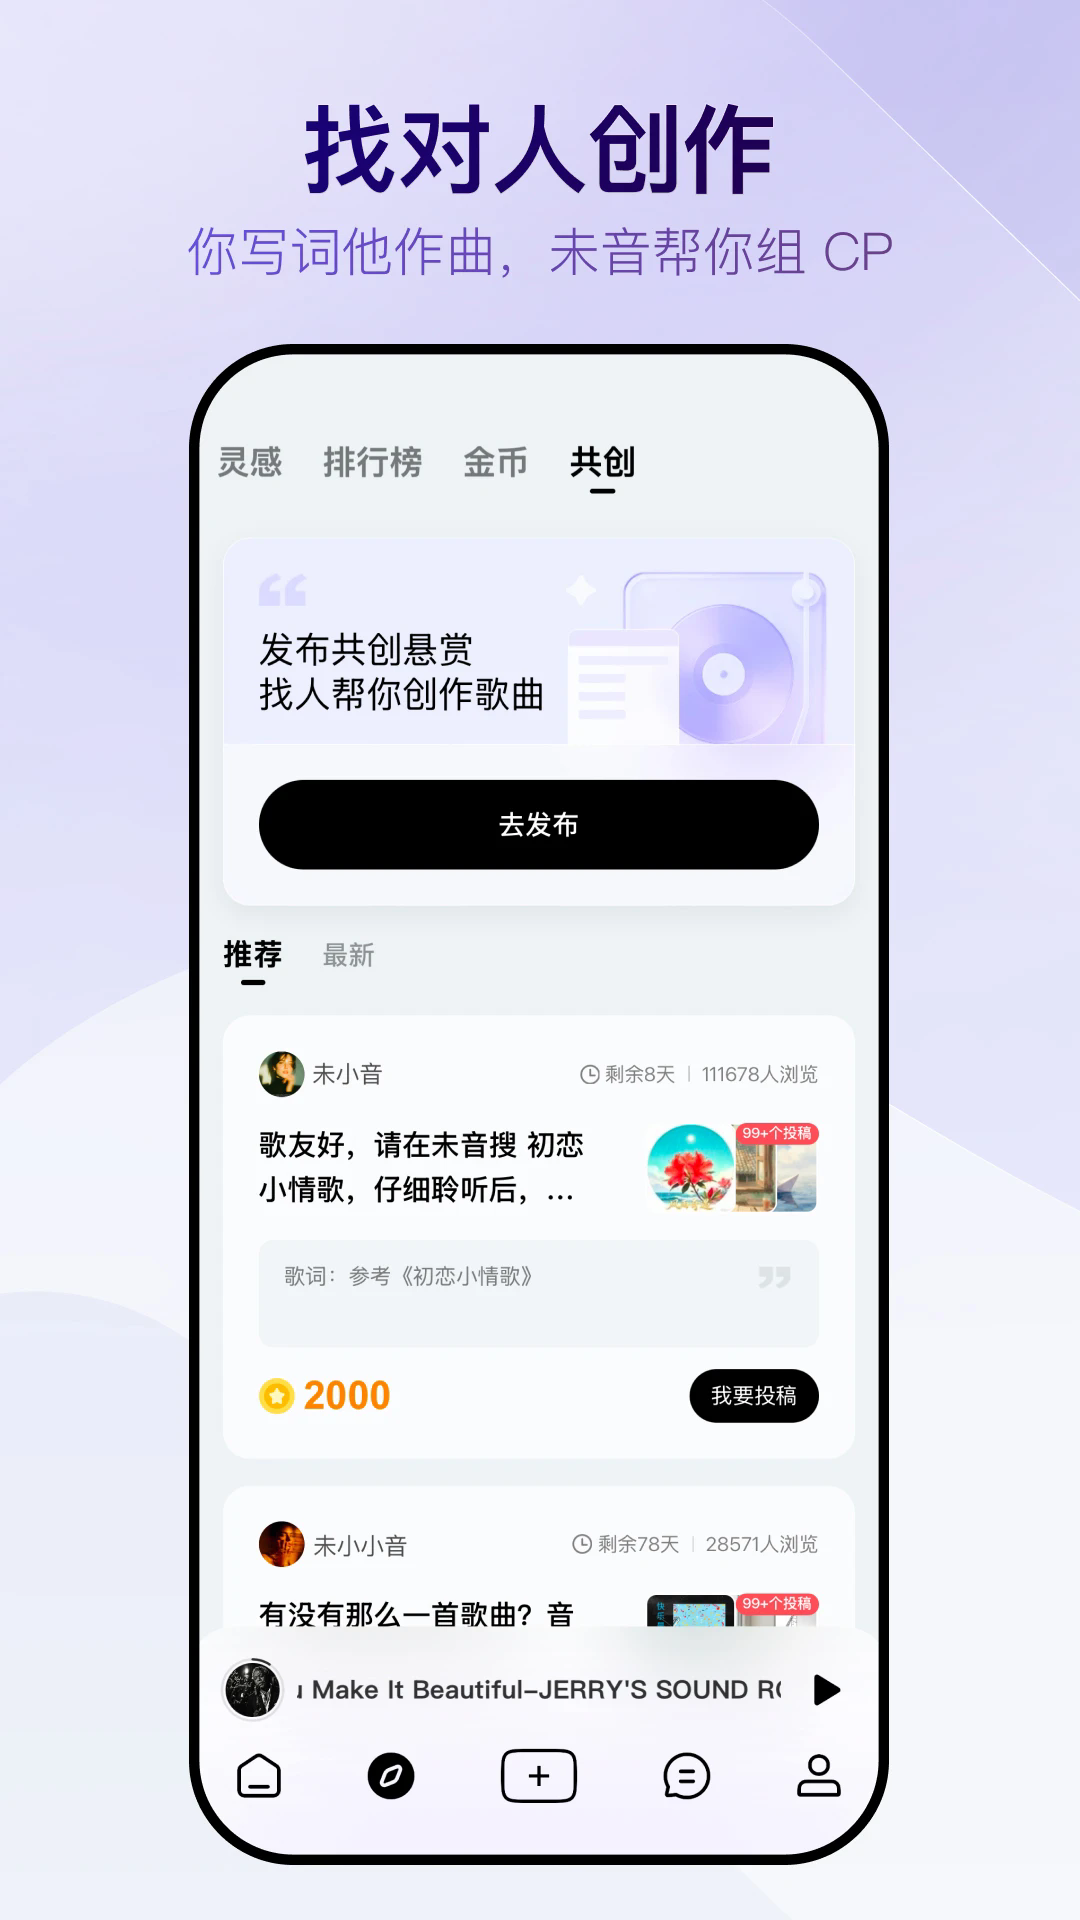
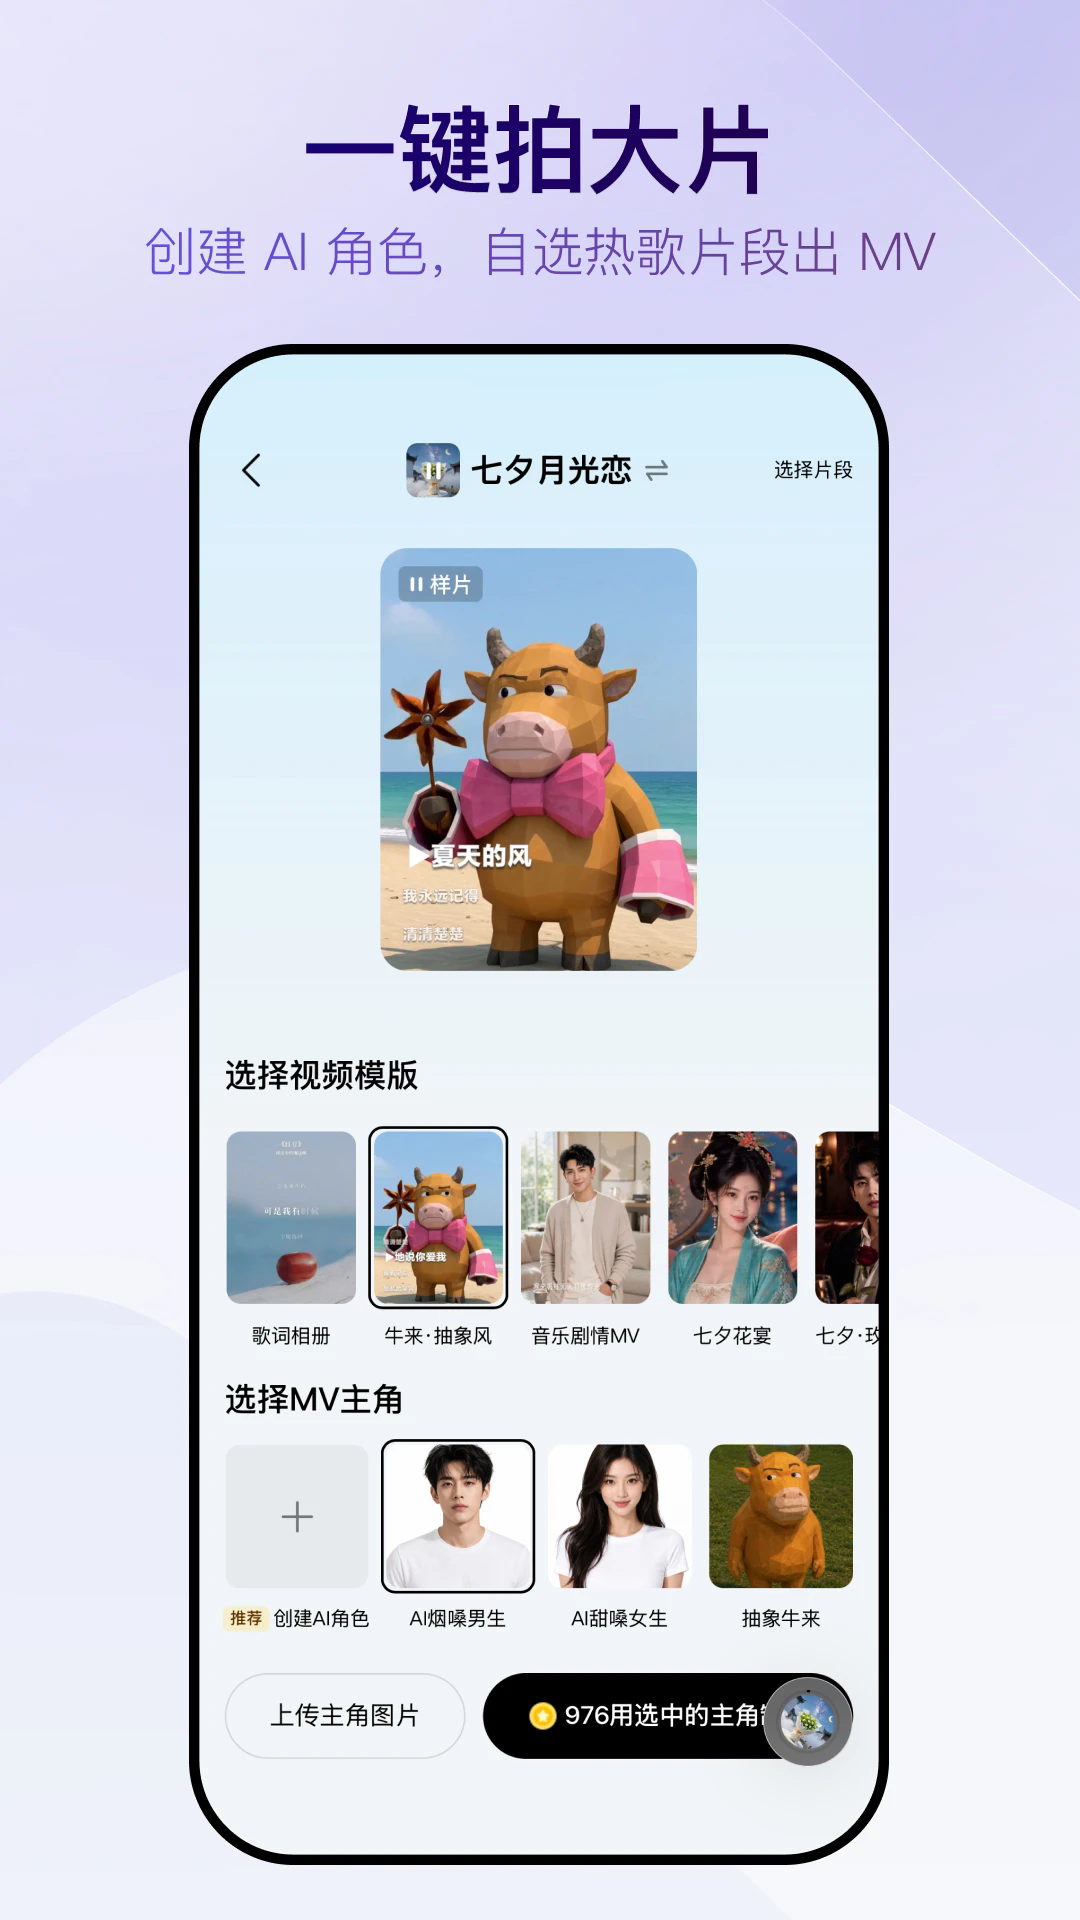
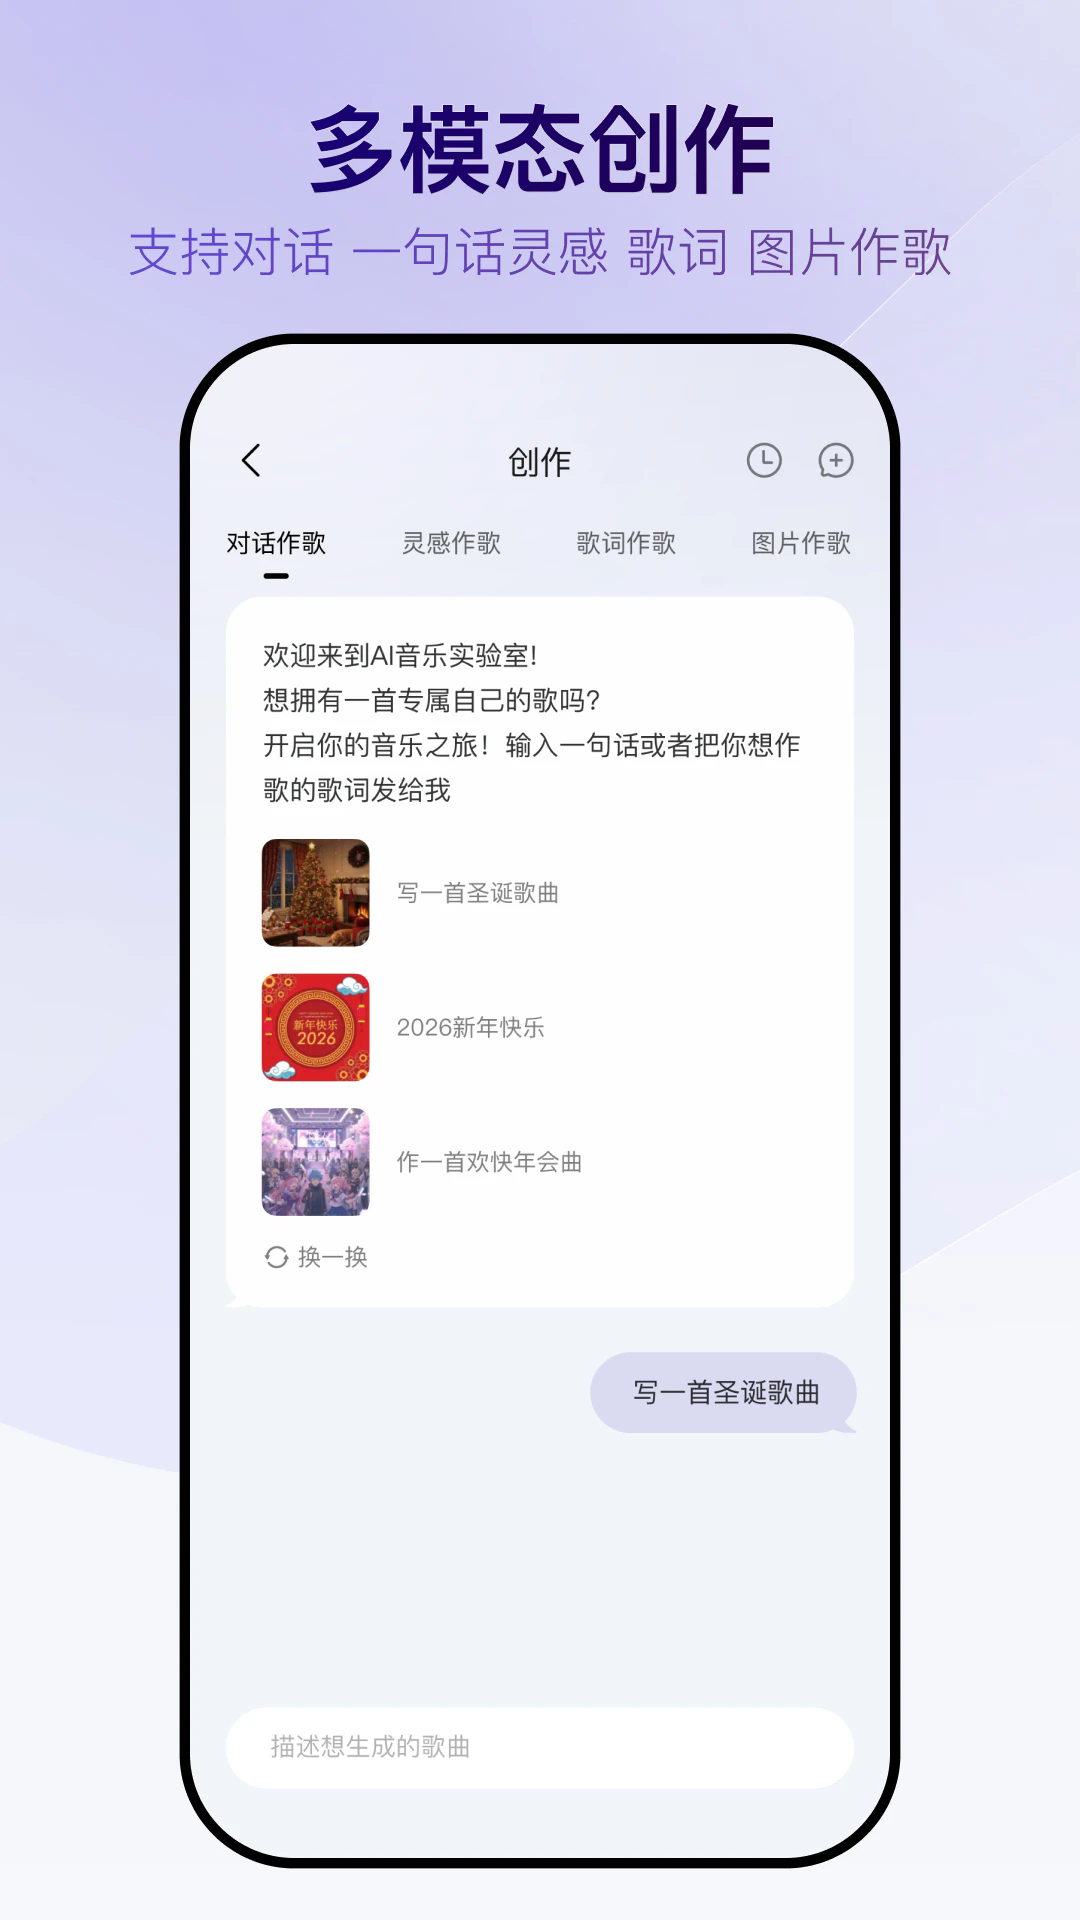
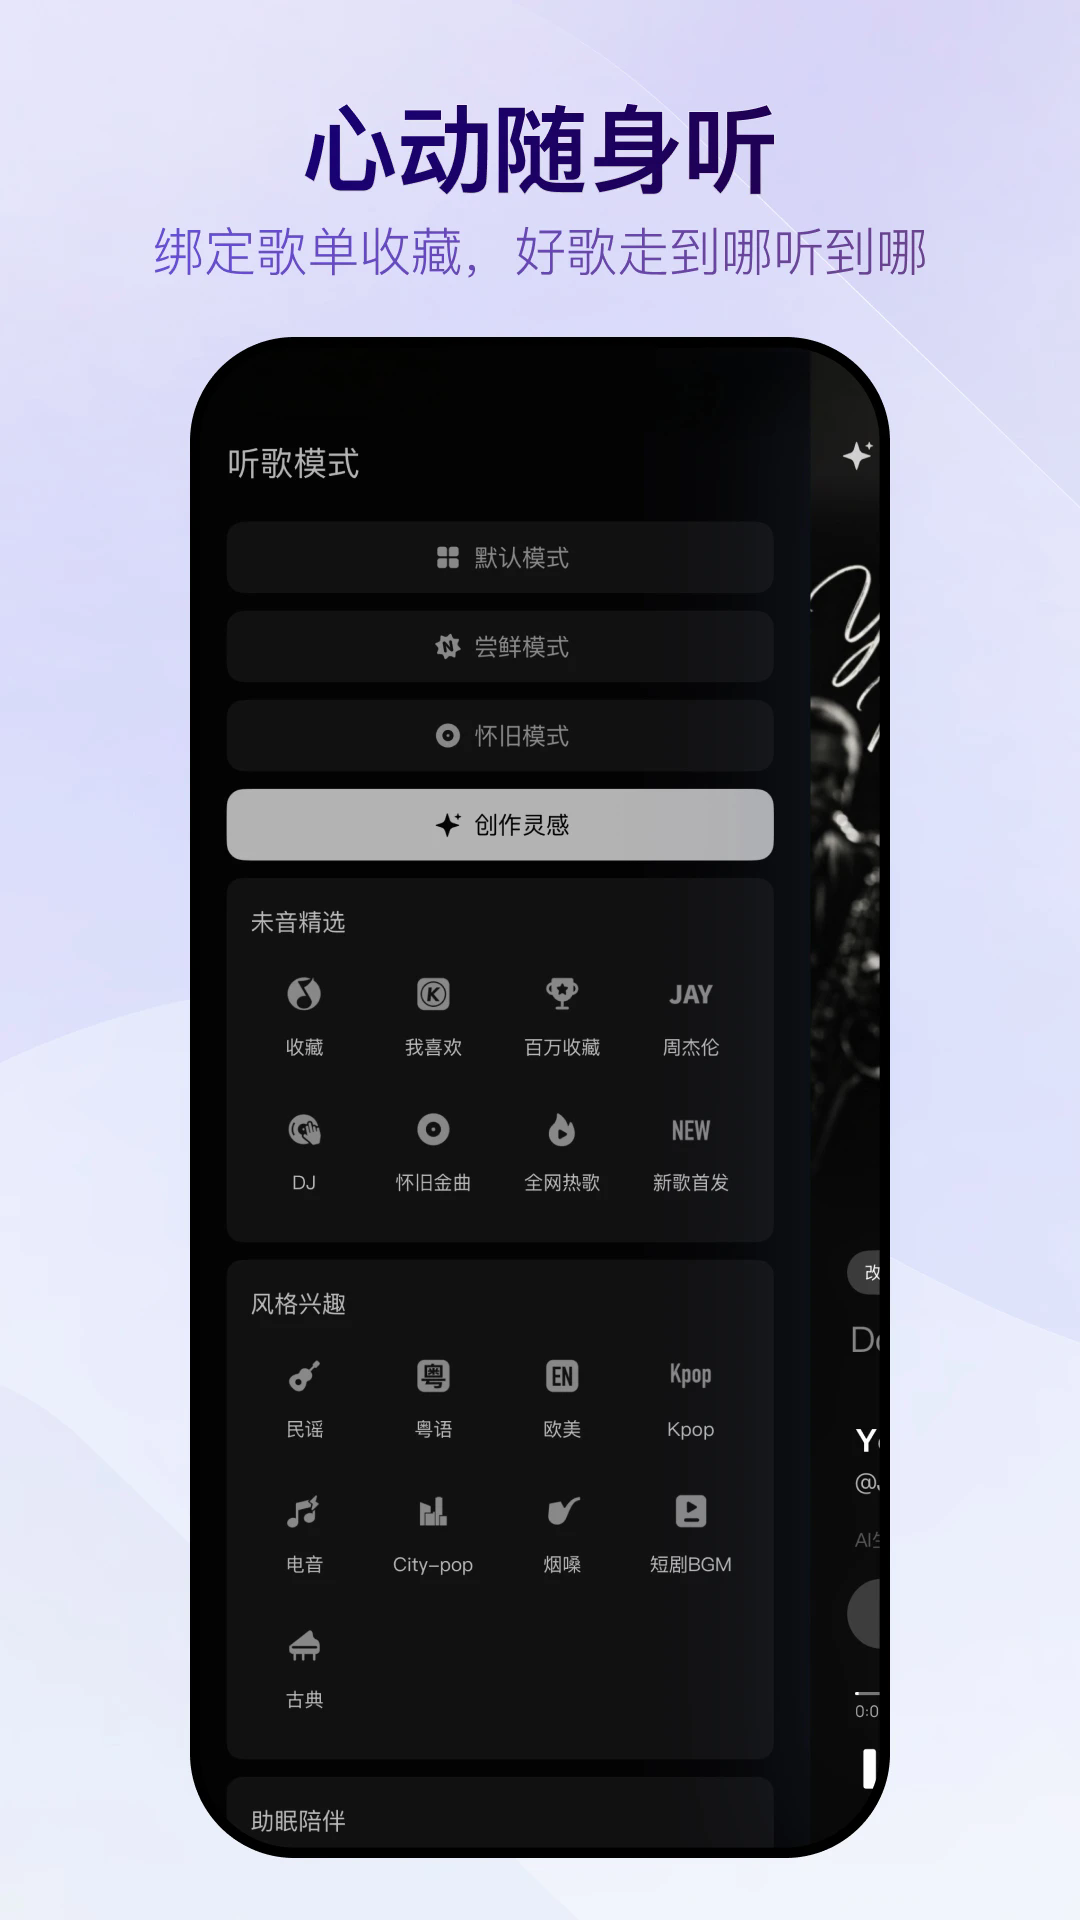
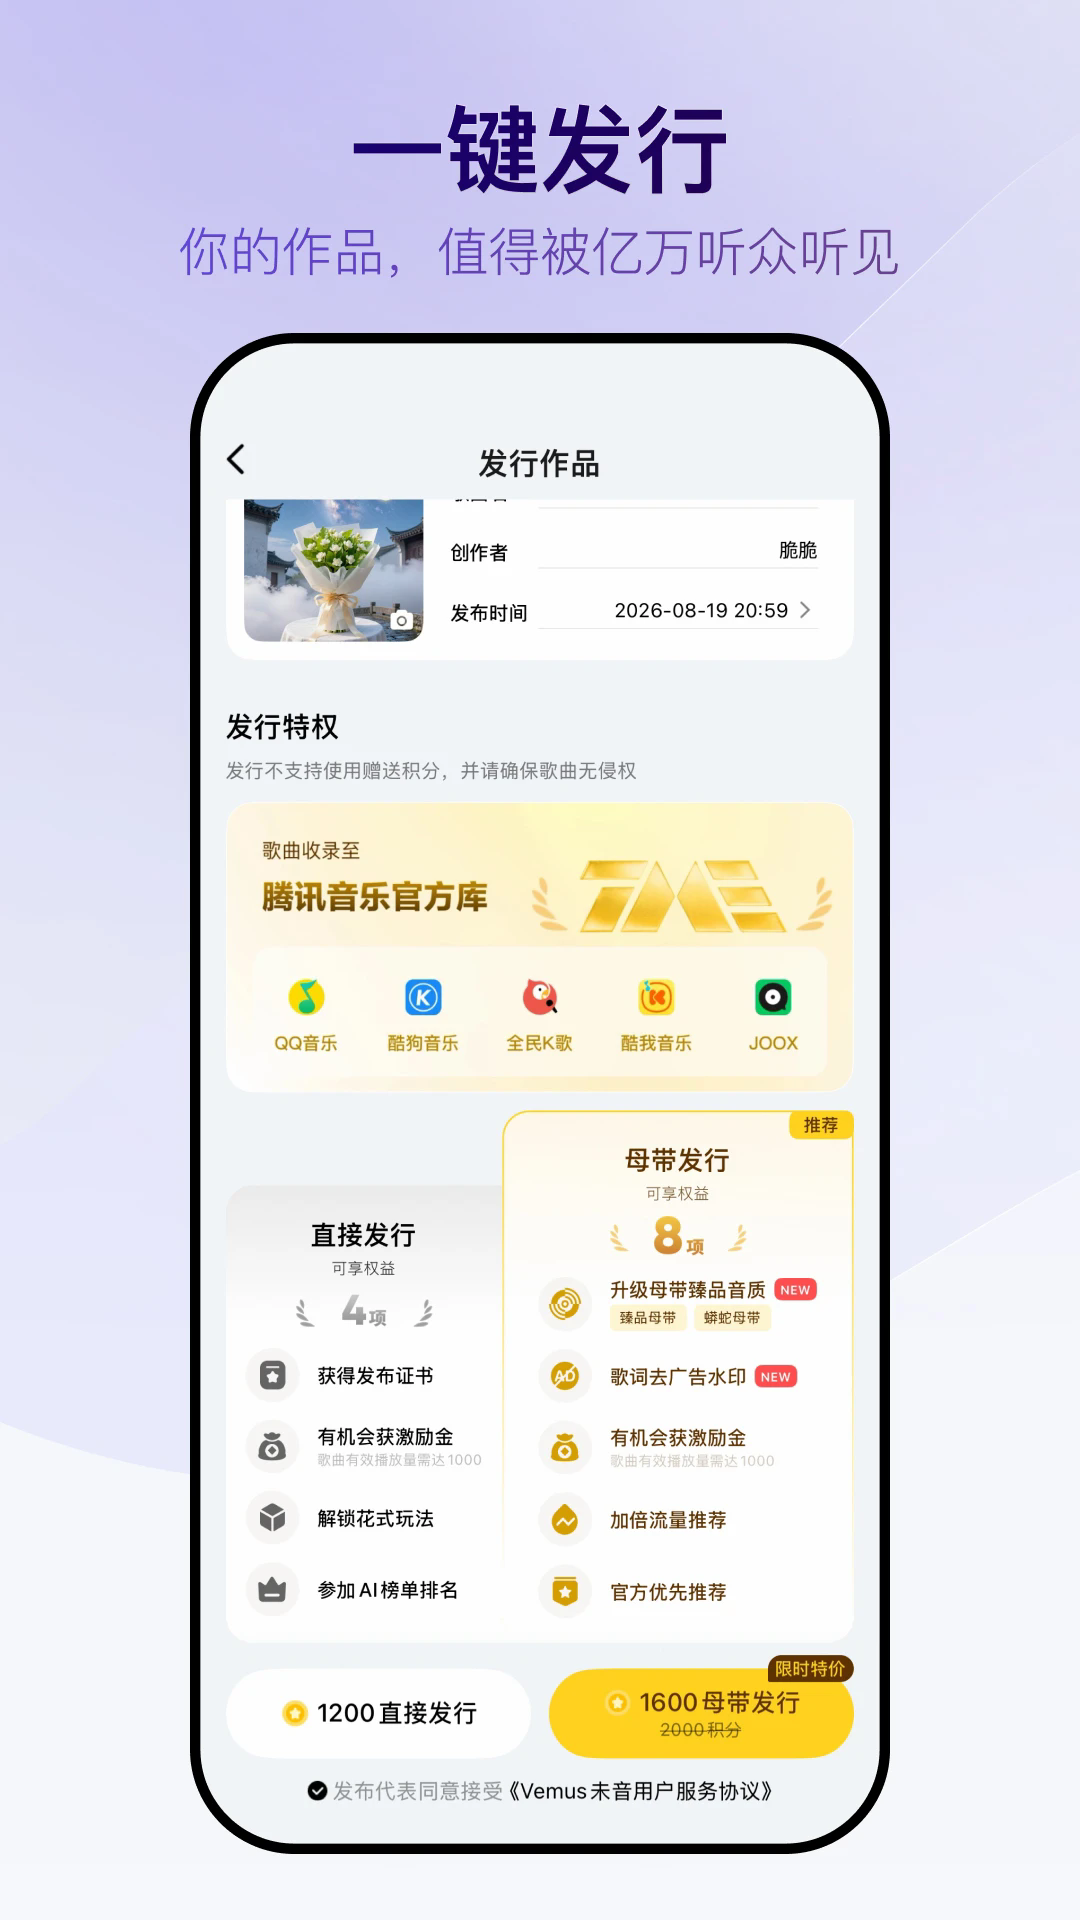
《Vemus未音》是一款打破传统音乐创作门槛的智能移动应用,专为渴望表达情感却苦于缺乏乐理知识的普通用户设计;它不仅是一个简单的录音工具,更是一座随身携带的灵感捕捉站,通过深度融合前沿的人工智能算法,软件能够精准解析用户哼唱的旋律或输入的关键词,瞬间生成具备专业水准的和弦、编曲与混音效果,无论是想为朋友圈视频配上一段独一无二的背景音乐,还是记录脑海中稍纵即逝的作曲灵感,这款应用都能以极简的操作流程,让每个人在指尖轻触间享受成为“音乐制作人”的乐趣。
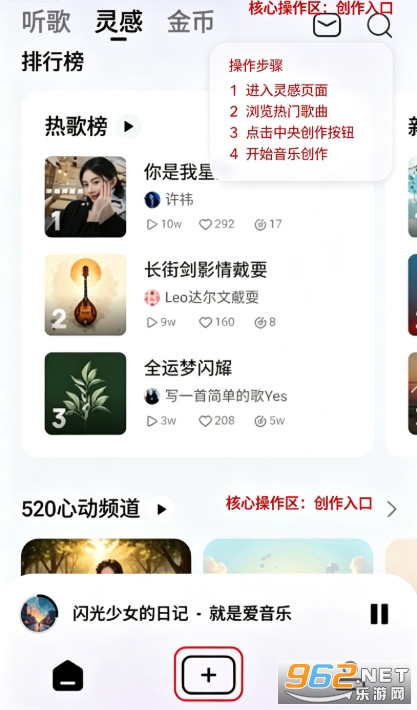
1、在听歌页面点击下方做同款音乐就能进行创作
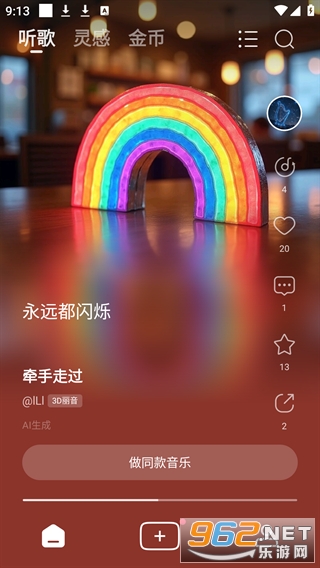
2、在灵感页面直接点击上方作歌图标或下方加号图标都能进行创作
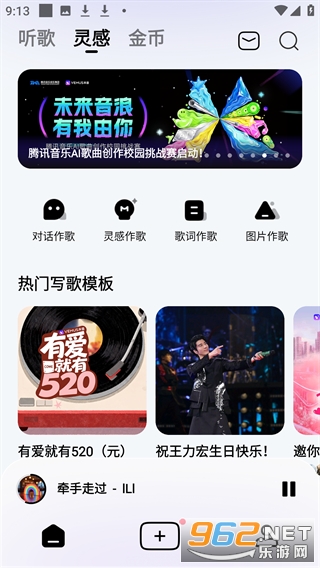
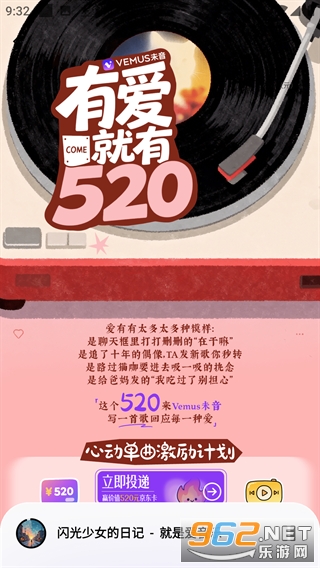
3、点击热歌写歌模板或是下滑找到排行榜寻找创作灵感
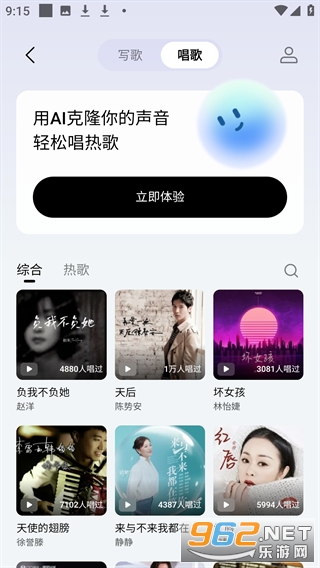
4、来到创作页面点击唱歌能用AI克隆自己的声音唱歌
Vemus未音重新定义移动端音乐制作的边界,官方定位清晰指向“低门槛、高效率、高质感”,旨在消除专业音频工作站(DAW)带来的复杂操作壁垒,软件内置庞大的风格化模型库,涵盖流行、电子、古典、爵士、民谣等多种主流音乐流派,用户无需购买昂贵的乐器或学习复杂的五线谱知识,只需通过直观的图形化界面,选择心仪的风格模板,输入简单的情绪关键词或直接录制一段人声Demo,AI引擎便会自动补全伴奏、调整节奏并优化音质;核心优势在于将复杂的音频处理过程黑盒化,保留最纯粹的创意输出环节,让音乐创作回归表达本身。
1、明确创作主题与情绪基调
在开始之前,先在脑海中构想一个具体的场景,例如“清晨咖啡店的慵懒午后”或“雨夜街头的孤独感”
进入软件首页后,不要盲目点击随机生成,而是在提示词输入框中用自然语言描述这个场景
尽量包含乐器偏好(如钢琴、吉他)、速度快慢(BPM参考)以及情感色彩(忧伤、欢快、激昂)
2、选择合适的风格预设进行匹配
根据第一步确定的基调,在风格分类栏中选择对应的标签
如果不确定哪种风格最合适,可以尝试混合模式,比如勾选“Lo-Fi”和“Jazz”,观察预览波形图的差异
选定风格后,点击“生成”按钮,等待几秒钟,系统会提供多个版本的候选曲目
3、利用编辑工具进行局部微调
选中满意的基础曲目后,进入编辑界面,这里可以单独替换某些乐器的音色
检查段落结构,如果副歌部分不够强烈,可以尝试增加鼓组的力度或叠加一层弦乐铺底
对于哼唱的人声部分,若发现音准偏差较大,可使用软件的自动修音功能进行平滑处理
4、导出前的混音平衡检查
完成所有修改后,点击预览完整歌曲
重点关注人声与伴奏的比例是否协调,高频是否刺耳,低频是否浑浊
如果发现某一部分音量过大,可在混音台面板中适当拉低该轨道的电平
最后,确认无误后,选择所需的音频格式(MP3用于分享,WAV用于后续专业处理)进行导出
1、区别于传统仅依赖MIDI音符的软件,本应用深度集成自然语言处理技术
2、AI会自动分析图片的色彩、构图与氛围,从而推导出相匹配的旋律与配器,让视觉艺术直接转化为听觉体验
3、软件采用先进的流式生成架构,允许用户在播放过程中实时修改参数
4、内置的音乐社区模块让用户可以将自己的作品一键发布,并邀请其他用户进行“接力创作”
5、此外,云同步功能确保你在手机端未完成的项目,可以在平板或网页端无缝续接,数据实时更新
许多新手习惯直接要求生成一首完整的3-5分钟歌曲,这往往导致中段结构混乱、重复度高
最佳策略是分块生成:先确定主歌(Verse)的动机,再生成副歌(Chorus),最后填充桥段(Bridge)与尾奏
分步构建不仅便于控制细节,还能在每一步之间进行人工筛选与拼接,确保整体逻辑严密
如果你心中有一首特定的经典歌曲作为模仿对象,可以使用APP内的“参考提取”功能
导入该歌曲的一个短片段(10-15秒),软件会提取其和声进程与节奏特征,并以此为基础生成全新旋律
由于AI运算涉及大量临时数据交换,随着使用时间增长,手机存储空间不足可能会影响响应速度
建议在设置菜单中每周执行一次“深度清理”,删除不再需要的草稿与中间文件,保证应用始终处于最佳运行状态
为了追求极致的个性化,不妨在生成基底音乐后,导入自己录制的现实环境音(如雨声、键盘敲击声、街道嘈杂声)
将这些非音乐性元素作为背景层叠加在AI生成的旋律之上,能瞬间提升作品的叙事感与生活气息

Trust官方最新版 44.2M / 中文 / 安卓实用工具
VEICHI数字化安卓版 49.5M / 中文 / 安卓办公商务

耳遇语音最新版 63.6M / 中文 / 安卓聊天社交
YeeMall官方版 114.3M / 中文 / 安卓实用工具
饭团外卖Fantuan Delivery官方版 161.9M / 中文 / 安卓购物优惠

Honor of Kings王者荣耀国际服 637.6M / 英文 / 安卓角色扮演
王者荣耀ios最新版 2.30G / 中文 / iphone角色扮演

汤姆猫跑酷破解版 189.2M / 中文 / 安卓休闲益智
托卡世界无广告全解锁版 684.3M / 中文 / 安卓休闲益智
火影忍者手游ios版 3.80G / 中文 / iphone动作游戏

 TikTok
 微信抢红包软件

 酷我音乐永久免费版app
 KineraMusic官方版
 全免音乐播放app
 tcaudio官方正版
 酷我音乐手表版vip版
 酷我音乐极简版vip版本
 曼波app动漫软件
玩家留言